Category: Website

  • Merancang Context Loading yang Efisien untuk AI Coding Assistant

    Merancang Context Loading yang Efisien untuk AI Coding Assistant

    Merancang Context Loading yang Efisien untuk AI Coding Assistant

    Bagaimana Mengurangi Pemborosan Token Tanpa Mengorbankan Pemahaman Proyek

    AI coding assistant seperti Claude Code, Codex, Cursor, dan berbagai agent berbasis LLM dapat mempercepat proses pengembangan aplikasi secara signifikan.

    Namun, ketika proyek mulai membesar, muncul sebuah masalah yang sering tidak terlihat pada tahap awal:

    Semakin besar proyek, semakin banyak konteks yang harus dibaca oleh AI sebelum bisa mulai bekerja.

    Pada proyek kecil, kita mungkin cukup memberikan satu file instruksi, beberapa dokumentasi, lalu meminta AI mengerjakan sebuah fitur.

    Tetapi seiring waktu, proyek biasanya mulai memiliki:

    • dokumentasi arsitektur,
    • aturan coding,
    • business rules,
    • struktur database,
    • keputusan teknis,
    • dokumentasi setiap modul,
    • prosedur deployment,
    • panduan testing,
    • catatan keamanan,
    • dan berbagai informasi lainnya.

    Masalahnya, tidak semua informasi tersebut relevan untuk setiap pekerjaan.

    Ketika AI harus membaca semuanya setiap memulai sesi, kita menghadapi beberapa konsekuensi:

    1. Penggunaan token menjadi lebih besar.
    2. Waktu orientasi agent menjadi lebih lama.
    3. Informasi penting mudah tenggelam di antara informasi yang tidak relevan.
    4. Risiko instruksi saling bertentangan meningkat.
    5. AI bisa kehilangan fokus terhadap pekerjaan yang sedang dilakukan.

    Artikel ini membahas sebuah pendekatan untuk mengatur konteks proyek secara bertingkat, sehingga AI hanya membaca informasi yang benar-benar diperlukan.

    Konsep utamanya sederhana:

    Jangan memuat seluruh pengetahuan proyek sejak awal. Muat konteks secara bertahap berdasarkan kebutuhan.


    Masalah Context Loading pada Workflow AI Coding

    Bayangkan kita memiliki proyek aplikasi yang cukup besar.

    Di dalamnya terdapat beberapa dokumen seperti:

    CLAUDE.md
    architecture.md
    database-schema.md
    security-guidelines.md
    api-conventions.md
    deployment-guide.md
    testing-guide.md
    module-auth.md
    module-payment.md
    module-notification.md
    

    Cara paling sederhana adalah meminta AI membaca semua file tersebut sebelum mulai bekerja.

    Workflow-nya menjadi seperti ini:

    Agent memulai sesi
    ↓
    Membaca instruksi utama
    ↓
    Membaca seluruh dokumentasi
    ↓
    Mencari file yang berkaitan
    ↓
    Membaca source code
    ↓
    Memahami konteks
    ↓
    Mulai mengerjakan task
    

    Pendekatan ini memang memberikan konteks lengkap, tetapi tidak selalu efisien.

    Ketika task-nya hanya memperbaiki tombol pada halaman tertentu, apakah AI benar-benar perlu membaca dokumentasi deployment, sistem pembayaran, struktur notifikasi, dan seluruh keputusan arsitektur?

    Kemungkinan besar tidak.

    Yang sebenarnya kita butuhkan adalah mekanisme seperti ini:

    Agent memulai sesi
    ↓
    Membaca instruksi global yang ringkas
    ↓
    Mengidentifikasi konteks task
    ↓
    Mengambil aturan dan dokumentasi yang relevan
    ↓
    Membaca source code terkait
    ↓
    Mulai bekerja
    

    Perbedaannya terlihat kecil, tetapi pada proyek besar dampaknya bisa sangat signifikan.


    Kesalahpahaman tentang Memecah CLAUDE.md

    Salah satu ide yang cukup alami adalah memecah satu file CLAUDE.md besar menjadi banyak file Markdown kecil.

    Contohnya:

    CLAUDE.md
    docs/
    ├── architecture.md
    ├── security.md
    ├── database.md
    ├── testing.md
    └── deployment.md
    

    Kemudian CLAUDE.md dijadikan semacam index:

    @docs/architecture.md
    @docs/security.md
    @docs/database.md
    @docs/testing.md
    @docs/deployment.md
    

    Struktur tersebut memang jauh lebih rapi untuk manusia.

    Namun, berdasarkan dokumentasi Claude Code, file yang dimasukkan menggunakan mekanisme @import tetap dimuat ke dalam context window.

    Artinya:

    Satu CLAUDE.md besar
    

    dan:

    CLAUDE.md yang mengimpor banyak file
    

    dapat menghasilkan penggunaan context yang hampir sama.

    Memecah file menggunakan @import bermanfaat untuk:

    • organisasi dokumentasi,
    • kemudahan maintenance,
    • pembagian tanggung jawab file,
    • kenyamanan membaca.

    Tetapi bukan untuk mengurangi token.

    Kesimpulannya:

    @import adalah alat organisasi, bukan mekanisme lazy loading.

    Untuk menghemat context, kita membutuhkan mekanisme yang benar-benar hanya memuat informasi ketika diperlukan.


    Tiga Mekanisme Lazy Loading di Claude Code

    Claude Code menyediakan beberapa mekanisme yang lebih cocok untuk context loading bertahap.

    1. Path-Scoped Rules

    Claude Code mendukung file aturan di dalam folder:

    .claude/rules/
    

    Aturan tersebut dapat diberi frontmatter paths.

    Contoh:

    ---
    paths:
      - "app/api/**/*.ts"
    ---
    
    # API Route Conventions
    
    - Semua input harus divalidasi.
    - Response harus menggunakan format standar.
    - Error internal tidak boleh ditampilkan kepada user.
    - Setiap endpoint sensitif harus memiliki authorization check.
    

    Rule tersebut hanya relevan ketika Claude bekerja dengan file yang cocok dengan pattern:

    app/api/**/*.ts
    

    Jika Claude hanya mengedit komponen frontend, rule untuk API tidak perlu masuk ke context.

    Contoh struktur:

    .claude/
    └── rules/
        ├── api-routes.md
        ├── components.md
        ├── database.md
        ├── migrations.md
        └── testing.md
    

    Setiap rule memiliki cakupan path masing-masing.

    Path-scoped rules cocok untuk menjawab pertanyaan:

    Ketika mengedit jenis file ini, aturan apa yang harus dipatuhi?

    Contohnya:

    • aturan API route,
    • aturan React component,
    • aturan database query,
    • aturan migration,
    • aturan testing,
    • aturan server action,
    • aturan keamanan file tertentu.

    Hal penting yang perlu diperhatikan, rule tanpa paths dapat tetap dianggap sebagai instruksi global.

    Jadi, jika tujuan kita adalah lazy loading, pastikan aturan tersebut benar-benar memiliki cakupan path yang sesuai.


    2. Nested CLAUDE.md

    Selain CLAUDE.md utama di root proyek, kita juga dapat menempatkan CLAUDE.md di dalam subfolder tertentu.

    Contohnya:

    project/
    ├── CLAUDE.md
    └── src/
        └── modules/
            ├── authentication/
            │   ├── CLAUDE.md
            │   └── ...
            ├── payment/
            │   ├── CLAUDE.md
            │   └── ...
            └── notification/
                ├── CLAUDE.md
                └── ...
    

    CLAUDE.md utama berisi aturan yang berlaku untuk seluruh proyek.

    Sementara itu, CLAUDE.md di dalam modul payment hanya dibutuhkan ketika agent bekerja di dalam modul payment.

    Nested CLAUDE.md cocok untuk menjelaskan:

    • tanggung jawab modul,
    • batas modul,
    • invariant domain,
    • entry point utama,
    • hubungan dengan modul lain,
    • hal-hal yang tidak boleh dilakukan modul tersebut.

    Contohnya:

    # Payment Module
    
    ## Responsibility
    
    Modul ini menangani pembuatan transaksi, komunikasi dengan payment provider,
    callback, reconciliation, dan perubahan status pembayaran.
    
    ## Boundaries
    
    - Tidak menangani entitlement user.
    - Tidak mengirim email secara langsung.
    - Tidak mengakses komponen UI.
    - Semua komunikasi provider harus melalui adapter.
    
    ## Main Entry Points
    
    - createPayment()
    - handlePaymentCallback()
    - reconcilePayment()
    

    Nested CLAUDE.md menjawab pertanyaan:

    Apa fungsi modul ini dan bagaimana batas tanggung jawabnya?

    Ini berbeda dengan path-scoped rule.

    Path-scoped rule menjelaskan aturan saat mengedit jenis file tertentu, sedangkan nested CLAUDE.md menjelaskan mental model dari sebuah area atau modul.


    3. Skills

    Tidak semua instruksi perlu aktif setiap saat.

    Beberapa instruksi hanya dibutuhkan ketika kita menjalankan workflow tertentu, misalnya:

    • membuat migration,
    • menambahkan payment provider,
    • melakukan deployment,
    • menjalankan security review,
    • membuat release,
    • memperbaiki CI,
    • memperbarui dokumentasi,
    • melakukan audit repository.

    Instruksi seperti ini lebih cocok dijadikan skill.

    Contoh struktur:

    .claude/
    └── skills/
        ├── deploy-production/
        │   └── SKILL.md
        ├── create-migration/
        │   └── SKILL.md
        ├── security-review/
        │   └── SKILL.md
        └── update-documentation/
            └── SKILL.md
    

    Skill cocok untuk prosedur yang memiliki:

    1. kondisi awal,
    2. urutan proses,
    3. checkpoint,
    4. validasi,
    5. output akhir.

    Sebagai contoh, prosedur deployment mungkin mencakup:

    Periksa status Git
    ↓
    Jalankan test
    ↓
    Build aplikasi
    ↓
    Buat backup
    ↓
    Deploy
    ↓
    Verifikasi production
    ↓
    Buat laporan
    

    Prosedur ini tidak perlu berada di context setiap kali agent hanya memperbaiki tampilan tombol.

    Skill dapat dimuat ketika:

    • dipanggil secara eksplisit,
    • atau dianggap relevan dengan task yang sedang dikerjakan.

    Dengan demikian, skills menggunakan konsep progressive disclosure, yaitu informasi lengkap baru diberikan ketika benar-benar diperlukan.


    Auto Memory sebagai Catatan Pembelajaran Agent

    Claude Code juga memiliki mekanisme auto memory.

    Secara konseptual, strukturnya menyerupai:

    memory/
    ├── MEMORY.md
    ├── debugging.md
    ├── api-conventions.md
    ├── environment-notes.md
    └── testing-notes.md
    

    MEMORY.md berfungsi sebagai index ringkas yang dibaca saat sesi dimulai.

    Sementara file topik lain dapat dibaca ketika dibutuhkan.

    Pola ini menunjukkan bahwa konsep berikut memang valid:

    Index kecil selalu tersedia, detail dibaca on-demand.

    Namun, auto memory sebaiknya tidak dianggap sebagai dokumentasi resmi proyek.

    Auto memory lebih cocok untuk menyimpan pembelajaran seperti:

    • command tertentu bermasalah pada sistem operasi tertentu,
    • test tertentu membutuhkan environment khusus,
    • kebiasaan lokal dalam repository,
    • koreksi yang berulang kali diberikan kepada agent,
    • shortcut atau teknik debugging tertentu.

    Auto memory sebaiknya diperlakukan sebagai inbox pembelajaran.

    Jika sebuah informasi sudah:

    • terbukti benar,
    • berlaku untuk semua anggota tim,
    • penting untuk konsistensi proyek,
    • dan perlu menjadi aturan resmi,

    maka informasi tersebut sebaiknya dipindahkan ke salah satu tempat berikut:

    CLAUDE.md
    Path-scoped rule
    Nested CLAUDE.md
    Skill
    Canonical documentation
    

    Memisahkan Instruksi dan Pengetahuan

    Salah satu kesalahan yang sering terjadi adalah mencampurkan semua jenis informasi ke dalam CLAUDE.md.

    Padahal, tidak semua informasi memiliki fungsi yang sama.

    Ada perbedaan antara:

    • instruksi,
    • fakta sistem,
    • prosedur,
    • hubungan source code,
    • dan konteks task.

    Sebagai contoh:

    Semua perubahan status pembayaran harus melalui PaymentService.
    

    Ini adalah invariant atau aturan sistem.

    Informasi tersebut cocok ditempatkan dalam rule atau dokumentasi modul.

    Namun informasi seperti:

    PaymentService berada di file tertentu dan dipanggil oleh empat file lain.
    

    adalah hubungan source code yang dapat berubah sewaktu-waktu.

    Jika hubungan tersebut ditulis manual dalam dokumentasi, informasinya mudah menjadi basi.

    Untuk jenis pengetahuan seperti ini, knowledge graph dapat membantu.


    Memanfaatkan Knowledge Graph dengan Graphify

    Graphify adalah tool yang dapat memetakan source code, dokumentasi, PDF, gambar, dan berbagai jenis file menjadi sebuah knowledge graph.

    Untuk source code, Graphify menggunakan parsing berbasis AST atau Abstract Syntax Tree.

    Dari source code, Graphify dapat menemukan hubungan seperti:

    • file mengimpor file lain,
    • fungsi memanggil fungsi lain,
    • class menggunakan interface,
    • class mewarisi class lain,
    • route terhubung ke service,
    • service terhubung ke database,
    • test berhubungan dengan modul tertentu.

    Hasilnya disimpan dalam beberapa file:

    graphify-out/
    ├── graph.json
    ├── GRAPH_REPORT.md
    └── graph.html
    

    graph.json menjadi indeks hubungan proyek yang bisa ditanya kembali.

    Contoh query:

    graphify query "Bagaimana alur authentication bekerja?"
    
    graphify query "Apa yang terpengaruh jika struktur user diubah?"
    
    graphify path "CheckoutPage" "PaymentProvider"
    
    graphify explain "PaymentService"
    

    Alih-alih membaca seluruh repository, agent dapat menggunakan graph untuk menemukan bagian yang kemungkinan besar relevan.

    Workflow-nya menjadi:

    Task diberikan
    ↓
    Agent menanyakan task kepada graph
    ↓
    Graph mengembalikan konsep dan file terkait
    ↓
    Agent membaca file yang relevan
    ↓
    Agent melakukan perubahan
    

    Graphify tidak menggantikan dokumentasi.

    Graphify menjawab pertanyaan:

    Apa yang berhubungan dengan bagian ini?

    Sementara dokumentasi menjawab:

    Mengapa sistem ini dirancang seperti ini dan aturan bisnis apa yang berlaku?

    Keduanya memiliki fungsi berbeda.


    Perbedaan Path Rules dan Knowledge Graph

    Path-scoped rules dan knowledge graph sering terlihat mirip, tetapi sebenarnya menyelesaikan masalah yang berbeda.

    Path-scoped rule

    Menjawab:

    Ketika mengedit file ini, aturan apa yang harus dipatuhi?

    Contoh:

    ---
    paths:
      - "src/modules/payment/providers/**/*.ts"
    ---
    
    # Payment Provider Rules
    
    - Semua request wajib memiliki timeout.
    - Jangan mencatat credential ke log.
    - Response provider harus divalidasi.
    - Callback harus idempotent.
    

    Knowledge graph

    Menjawab:

    File dan konsep apa yang terhubung dengan perubahan ini?

    Contoh query:

    graphify query "Apa yang terdampak jika callback payment diubah?"
    

    Graph dapat menemukan hubungan:

    Callback Handler
    → Payment Service
    → Transaction Table
    → Billing UI
    → Notification
    → Integration Tests
    

    Jadi:

    Rules
    = bagaimana agent harus bekerja
    
    Knowledge graph
    = di mana agent harus melihat
    

    Canonical Documentation Tetap Menjadi Source of Truth

    Meskipun knowledge graph sangat membantu, dokumentasi sistem tetap diperlukan.

    Ada banyak informasi yang tidak bisa diketahui hanya dengan membaca source code.

    Contohnya:

    • alasan sebuah keputusan dibuat,
    • business rules,
    • batasan produk,
    • kebijakan keamanan,
    • permission model,
    • lifecycle sebuah entitas,
    • risiko yang telah dipertimbangkan,
    • trade-off arsitektur,
    • keputusan yang sengaja tidak diimplementasikan.

    Informasi tersebut sebaiknya disimpan di dalam canonical documentation.

    Contoh struktur:

    docs/
    └── canonical/
        ├── system-overview.md
        ├── architecture.md
        ├── business-rules.md
        ├── database-schema.md
        ├── security-model.md
        ├── modules/
        └── decisions/
    

    Canonical documentation menjadi sumber resmi yang dapat dibaca oleh manusia dan AI.

    Knowledge graph kemudian dibuat dari:

    Source code
    +
    Canonical documentation
    

    Dengan demikian, graph dapat menghubungkan implementasi teknis dengan alasan dan keputusan di baliknya.

    Prinsip pentingnya:

    Dokumentasi kanonik diedit secara langsung. Graph dan index lainnya dihasilkan secara otomatis.


    Enam Lapisan Context Architecture

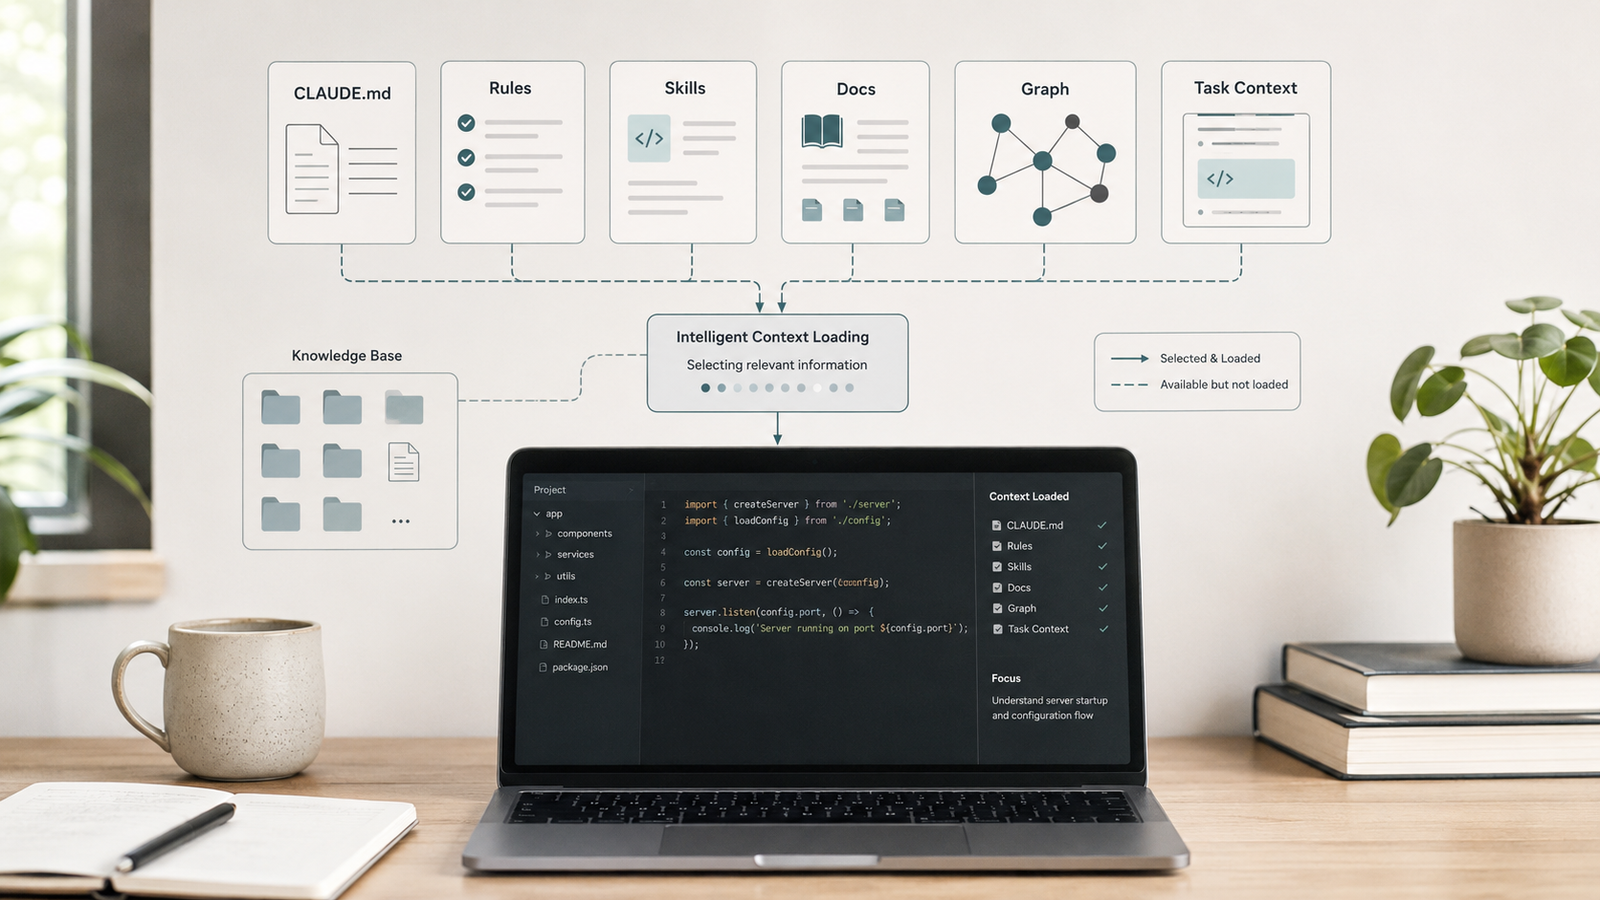
    Setelah memisahkan fungsi masing-masing mekanisme, kita dapat merancang arsitektur konteks dalam enam lapisan.

    1. Core Session Context

    Media:

    CLAUDE.md
    

    Berisi informasi yang harus diketahui dalam hampir setiap sesi:

    • identitas singkat proyek,
    • stack utama,
    • command penting,
    • source of truth,
    • larangan global,
    • aturan Git,
    • prinsip keamanan,
    • cara mencari konteks,
    • format laporan akhir.

    CLAUDE.md sebaiknya berfungsi sebagai bootstrap atau bootloader agent, bukan ensiklopedia proyek.


    2. Path Context

    Media:

    .claude/rules/
    Nested CLAUDE.md
    

    Berisi konteks yang hanya relevan ketika agent menyentuh bagian tertentu.

    Contohnya:

    • aturan API,
    • aturan component,
    • aturan migration,
    • mental model modul,
    • batas tanggung jawab domain.

    3. Procedural Context

    Media:

    Skills
    

    Berisi workflow multi-langkah yang hanya digunakan pada situasi tertentu.

    Contohnya:

    • deployment,
    • release,
    • security review,
    • migration,
    • integrasi baru,
    • audit repository.

    4. Canonical Knowledge

    Media:

    docs/canonical/
    

    Berisi pengetahuan resmi proyek:

    • arsitektur,
    • business rules,
    • database schema,
    • API contract,
    • keputusan teknis,
    • security model,
    • dokumentasi modul.

    5. Repository Knowledge

    Media:

    Graphify
    

    Berisi hubungan yang ditemukan atau dihitung dari source code dan dokumentasi:

    • dependency,
    • call flow,
    • import,
    • hubungan lintas file,
    • hubungan kode dengan dokumentasi,
    • kemungkinan area terdampak.

    6. Task Context

    Media:

    Task Context Package
    

    Task Context Package adalah kumpulan konteks yang dipilih secara khusus untuk satu pekerjaan.

    Contohnya:

    Task:
    Tambahkan logout pada menu profil.
    
    Relevant context:
    - authentication architecture,
    - session lifecycle,
    - UI component terkait,
    - fungsi sign out,
    - security rule,
    - test yang relevan,
    - acceptance criteria.
    

    Task Context Package dapat dihasilkan dari:

    Task
    +
    Canonical documentation
    +
    Knowledge graph
    +
    Relevant rules
    

    Hasil akhirnya adalah context kecil yang sangat spesifik.


    Alur Context Loading yang Ideal

    Dengan seluruh lapisan tersebut, context loading dapat berlangsung secara bertahap.

    CLAUDE.md utama
    ↓
    Identifikasi task
    ↓
    Query knowledge graph
    ↓
    Temukan source code dan dokumentasi terkait
    ↓
    Buka file yang relevan
    ↓
    Path-scoped rules aktif
    ↓
    Nested CLAUDE.md modul aktif
    ↓
    Skill dimuat jika diperlukan
    ↓
    Task Context Package terbentuk
    ↓
    Agent mulai bekerja
    

    Pendekatan ini jauh lebih efisien dibandingkan memuat semua dokumentasi sejak awal.


    Kerangka Keputusan: Informasi Ini Harus Diletakkan di Mana?

    Berikut checklist yang dapat digunakan setiap kali ada instruksi atau pengetahuan baru.

    Masukkan ke CLAUDE.md jika:

    • informasi wajib diketahui dalam hampir semua sesi,
    • ketidaktahuan terhadap informasi tersebut dapat menyebabkan kesalahan besar,
    • isinya singkat dan relatif stabil,
    • berlaku untuk seluruh repository.

    Contoh:

    • jangan menambah dependency tanpa persetujuan,
    • dokumentasi resmi berada di docs/canonical,
    • semua perubahan database harus memakai migration,
    • jangan pernah mencatat secret,
    • jalankan test utama sebelum menyelesaikan task.

    Masukkan ke path-scoped rule jika:

    • instruksi hanya berlaku pada pola file tertentu,
    • aturan dapat dipetakan ke glob path yang stabil,
    • tidak relevan untuk sebagian besar task lain.

    Contoh:

    • konvensi API route,
    • aturan React component,
    • standar migration,
    • validasi database query,
    • aturan test.

    Gunakan nested CLAUDE.md jika:

    • informasi menjelaskan satu modul atau domain besar,
    • seluruh file dalam folder tersebut memerlukan mental model yang sama,
    • informasi membahas responsibility dan boundary.

    Contoh:

    • tanggung jawab modul authentication,
    • batas modul payment,
    • invariant domain order,
    • entry point utama modul media.

    Jadikan skill jika:

    • informasinya merupakan prosedur multi-langkah,
    • hanya digunakan pada situasi tertentu,
    • memiliki checkpoint dan validasi,
    • dapat dipanggil sebagai workflow.

    Contoh:

    • deploy,
    • release,
    • audit keamanan,
    • membuat migration,
    • menambahkan provider baru.

    Masukkan ke canonical documentation jika:

    • merupakan fakta resmi sistem,
    • perlu dibaca manusia dan AI,
    • menjelaskan alasan, keputusan, atau aturan bisnis,
    • harus menjadi rujukan jangka panjang.

    Contoh:

    • arsitektur,
    • business rules,
    • schema database,
    • permission model,
    • keputusan teknis.

    Serahkan kepada knowledge graph jika:

    • informasi dapat dihitung dari repository,
    • hubungan tersebut sering berubah mengikuti kode,
    • menulisnya secara manual akan mudah basi.

    Contoh:

    • fungsi mana memanggil fungsi tertentu,
    • file mana menggunakan sebuah service,
    • test apa yang berkaitan dengan suatu modul,
    • route mana terhubung ke database tertentu.

    Masukkan ke auto memory jika:

    • merupakan pembelajaran lokal atau sementara,
    • belum layak menjadi aturan resmi,
    • berasal dari pengalaman agent selama bekerja.

    Contoh:

    • command tertentu gagal pada environment tertentu,
    • fixture tertentu sering terlupakan,
    • teknik debugging lokal.

    Gunakan hook, lint, test, atau CI jika:

    • aturan harus benar-benar dijalankan,
    • kegagalannya tidak boleh hanya bergantung pada ingatan AI.

    Contoh:

    Instruksi:
    Jalankan type check sebelum commit.
    
    Enforcement:
    Pre-commit hook atau CI menjalankan type check.
    

    Instruksi menjelaskan perilaku yang diharapkan.

    Hook dan CI memastikan perilaku tersebut benar-benar terjadi.


    Struktur Folder yang Dapat Digunakan

    Berikut salah satu contoh struktur yang dapat direplikasi pada berbagai proyek:

    project/
    ├── CLAUDE.md
    ├── AGENTS.md
    │
    ├── .claude/
    │   ├── rules/
    │   │   ├── frontend/
    │   │   ├── backend/
    │   │   ├── security/
    │   │   ├── testing/
    │   │   └── documentation/
    │   │
    │   ├── skills/
    │   │   ├── deploy/
    │   │   ├── release/
    │   │   ├── create-migration/
    │   │   ├── security-review/
    │   │   └── update-documentation/
    │   │
    │   └── settings.json
    │
    ├── docs/
    │   ├── canonical/
    │   │   ├── system-overview.md
    │   │   ├── architecture.md
    │   │   ├── business-rules.md
    │   │   ├── database-schema.md
    │   │   ├── security-model.md
    │   │   ├── modules/
    │   │   └── decisions/
    │   │
    │   └── generated/
    │       ├── task-context/
    │       ├── summaries/
    │       └── indexes/
    │
    ├── graphify-out/
    │   ├── graph.json
    │   ├── GRAPH_REPORT.md
    │   └── graph.html
    │
    └── src/
        └── modules/
            ├── authentication/
            │   └── CLAUDE.md
            ├── payment/
            │   └── CLAUDE.md
            └── notification/
                └── CLAUDE.md
    

    Struktur ini tidak harus diterapkan secara lengkap sejak hari pertama.

    Pada proyek kecil, kita mungkin hanya membutuhkan:

    CLAUDE.md
    docs/
    src/
    

    Ketika proyek berkembang, kita dapat menambahkan:

    Path-scoped rules
    Nested CLAUDE.md
    Skills
    Graphify
    Task Context Package
    

    Arsitektur konteks sebaiknya tumbuh mengikuti kompleksitas proyek.


    Contoh CLAUDE.md sebagai Bootstrap Agent

    Berikut contoh sederhana:

    # Project Agent Bootstrap
    
    ## Project
    
    Aplikasi ini adalah platform manajemen workflow berbasis web.
    
    ## Source of Truth
    
    - Source code berada di repository ini.
    - Dokumentasi resmi berada di `docs/canonical/`.
    - Keputusan arsitektur berada di `docs/canonical/decisions/`.
    - File generated tidak boleh diedit secara langsung.
    
    ## Core Commands
    
    - Development: `npm run dev`
    - Test: `npm test`
    - Type check: `npm run typecheck`
    - Build: `npm run build`
    
    ## Mandatory Rules
    
    - Jangan menambah package tanpa persetujuan.
    - Jangan mengubah database tanpa migration.
    - Jangan membaca atau menampilkan secret.
    - Jangan push sebelum pengujian utama lulus.
    - Jaga backward compatibility kecuali task menyatakan sebaliknya.
    
    ## Context Loading
    
    Sebelum membaca repository secara luas:
    
    1. Gunakan knowledge graph untuk memetakan konteks task.
    2. Baca hanya dokumentasi kanonik yang relevan.
    3. Baca source code yang berkaitan dengan task.
    4. Muat skill jika task membutuhkan prosedur khusus.
    5. Verifikasi keputusan penting terhadap source code atau dokumentasi resmi.
    
    ## Task Completion
    
    Laporan akhir harus mencakup:
    
    - perubahan yang dilakukan,
    - file yang berubah,
    - pengujian,
    - risiko,
    - status Git.
    

    File ini tidak mencoba menjelaskan seluruh proyek.

    Fungsinya adalah memberi tahu agent:

    • di mana sumber kebenaran berada,
    • bagaimana cara mencari konteks,
    • aturan global apa yang wajib dipatuhi,
    • seperti apa definisi task selesai.

    Mengurangi Beban Maintenance

    Arsitektur modular memang dapat menghemat context, tetapi juga bisa menciptakan maintenance baru.

    Untuk menghindarinya, ada beberapa prinsip yang dapat digunakan.

    1. Pisahkan Berdasarkan Tingkat Kestabilan

    Sangat stabil
    → CLAUDE.md utama
    
    Stabil per modul
    → Nested CLAUDE.md
    
    Stabil per jenis file
    → Path-scoped rules
    
    Berubah mengikuti source code
    → Knowledge graph
    
    Prosedural
    → Skills
    
    Pengetahuan resmi
    → Canonical documentation
    

    Jangan menaruh hubungan source code yang cepat berubah ke dalam instruksi global.


    2. Gunakan Glob Berdasarkan Boundary

    Lebih baik:

    paths:
      - "src/modules/payment/**/*.ts"
    

    Daripada:

    paths:
      - "src/modules/payment/services/payment-service.ts"
    

    Rule berbasis boundary modul lebih tahan terhadap perubahan struktur internal.


    3. Hindari Duplikasi

    Satu aturan idealnya memiliki satu lokasi utama.

    Contohnya:

    Aturan global keamanan
    → CLAUDE.md
    
    Aturan keamanan API
    → api-security rule
    
    Security architecture
    → canonical documentation
    
    Security review workflow
    → skill
    

    Jangan menyalin seluruh isi security documentation ke semua tempat.

    Cukup letakkan prinsip dan referensi sesuai fungsinya.


    4. Audit Secara Berkala

    Tidak perlu mengaudit context setiap hari.

    Audit dapat dilakukan pada:

    • akhir sprint,
    • akhir milestone,
    • setelah refactor besar,
    • setelah perubahan struktur folder,
    • sebelum onboarding agent baru.

    Hal yang dapat diperiksa:

    • apakah CLAUDE.md terlalu panjang,
    • apakah ada rule yang tidak pernah digunakan,
    • apakah ada skill yang tumpang tindih,
    • apakah auto memory perlu dipromosikan menjadi aturan resmi,
    • apakah graph masih sesuai dengan commit terbaru,
    • apakah terdapat instruksi yang bertentangan.

    Apakah Pendekatan Ini Benar-Benar Menghemat Token?

    Jawabannya, ya, terutama pada proyek yang:

    • berumur panjang,
    • memiliki banyak modul,
    • dikerjakan dalam banyak sesi,
    • menggunakan beberapa AI agent,
    • memiliki dokumentasi cukup besar,
    • sering mengalami perpindahan konteks.

    Namun penghematannya tidak selalu langsung terlihat pada hari pertama.

    Knowledge graph, rules, skills, dan dokumentasi modular membutuhkan investasi awal.

    Secara sederhana:

    Tanpa arsitektur context:
    
    20 sesi
    ×
    membaca banyak dokumentasi dan source code
    

    Dengan arsitektur context:

    1 kali membangun struktur context
    +
    20 sesi
    ×
    membaca context terpilih
    

    Semakin panjang umur proyek, semakin besar manfaatnya.


    Hal yang Perlu Diwaspadai

    Knowledge Graph Bukan Sumber Kebenaran

    Graph dapat memiliki hubungan hasil inferensi.

    Karena itu:

    Graph membantu menemukan sumber.
    Source code dan dokumentasi resmi tetap menjadi bukti.
    

    Keputusan penting tetap harus diverifikasi.


    Graph Dapat Menjadi Basi

    Jika source code berubah tetapi graph tidak diperbarui, agent dapat menerima informasi lama.

    Solusinya dapat berupa:

    • incremental update,
    • Git hook,
    • CI check,
    • pencatatan commit SHA,
    • pencatatan versi graph,
    • validasi graph terhadap repository HEAD.

    Terlalu Banyak Rules Juga Menjadi Masalah

    Memecah satu file besar menjadi puluhan aturan kecil tidak otomatis menghasilkan sistem yang lebih baik.

    Terlalu banyak rule dapat menyebabkan:

    • duplikasi,
    • konflik,
    • kesulitan menemukan sumber aturan,
    • maintenance yang berat.

    Setiap rule sebaiknya memiliki boundary yang jelas.


    Instruksi Tidak Sama dengan Enforcement

    Menulis:

    Selalu jalankan test.
    

    tidak menjamin test benar-benar dijalankan.

    Aturan kritis sebaiknya didukung oleh:

    • hooks,
    • CI,
    • lint,
    • type checking,
    • permission,
    • automated tests.

    Kesimpulan

    Efisiensi context loading bukan hanya soal memperpendek satu file instruksi.

    Masalah sebenarnya adalah menentukan:

    • informasi apa yang harus selalu tersedia,
    • informasi apa yang hanya relevan untuk path tertentu,
    • prosedur apa yang hanya perlu dimuat ketika digunakan,
    • pengetahuan apa yang menjadi sumber resmi,
    • hubungan apa yang sebaiknya dihitung otomatis,
    • dan konteks apa yang dibutuhkan untuk satu task tertentu.

    Arsitektur yang saya anggap cukup ideal adalah:

    CLAUDE.md
    = konteks inti setiap sesi
    
    Path-scoped rules
    = aturan berdasarkan file yang sedang dikerjakan
    
    Nested CLAUDE.md
    = mental model modul
    
    Skills
    = prosedur multi-langkah
    
    Canonical documentation
    = sumber kebenaran proyek
    
    Knowledge graph
    = peta hubungan source code dan dokumentasi
    
    Auto memory
    = inbox pembelajaran lokal
    
    Hooks dan CI
    = enforcement
    
    Task Context Package
    = konteks terpilih untuk satu pekerjaan
    

    Dengan pendekatan tersebut, AI coding assistant tidak harus mengetahui seluruh proyek sejak awal.

    Ia hanya perlu mengetahui:

    1. di mana mencari informasi,
    2. bagaimana memilih informasi yang relevan,
    3. aturan apa yang berlaku,
    4. dan sumber mana yang harus dipercaya.

    Tujuan akhirnya bukan sekadar mengurangi token.

    Tujuan yang lebih penting adalah membuat AI bekerja dengan konteks yang:

    • lebih fokus,
    • lebih akurat,
    • lebih mudah diverifikasi,
    • lebih mudah dirawat,
    • dan lebih konsisten di berbagai sesi.

    Saya masih terus mengeksplorasi pendekatan ini dan kemungkinan akan memperbarui artikel ini seiring bertambahnya pengalaman penggunaan di proyek nyata.

    Apabila Anda menggunakan Claude Code, Codex, Cursor, atau AI coding assistant lainnya, saya tertarik mengetahui bagaimana Anda mengatur context proyek.

    Apakah Anda menggunakan satu file instruksi besar, dokumentasi modular, skills, knowledge graph, atau pendekatan lain?

    Silakan bagikan pengalaman, kendala, dan struktur yang Anda gunakan di kolom komentar. Diskusi dari berbagai pengalaman mungkin dapat membantu kita menemukan pola kerja AI-assisted development yang lebih efektif dan efisien.


    Referensi

    Catatan: Fitur dan perilaku tool AI dapat berubah dengan cepat. Penjelasan teknis dalam artikel ini mengacu pada dokumentasi yang tersedia pada Juli 2026. Periksa dokumentasi resmi terbaru sebelum menerapkan konfigurasi pada proyek produksi.
  • Mengatasi 403 Forbidden Saat Deploy Next.js ke Hostinger dengan output: “standalone”

    Mengatasi 403 Forbidden Saat Deploy Next.js ke Hostinger dengan output: “standalone”

    Saya baru saja mengalami masalah yang cukup membingungkan ketika mencoba melakukan deployment aplikasi Next.js ke Hostinger Web App Hosting.

    Proses build berhasil. Tidak ada vulnerability. Dashboard Hostinger menunjukkan deployment telah selesai dan aplikasi berstatus Running.

    Namun, ketika domain dibuka, halaman yang tampil justru:

    403 Forbidden
    Access to this resource on the server is denied!

    Hal yang membuat masalah ini semakin membingungkan adalah aplikasi berjalan normal di localhost. Halaman utama bisa dibuka, endpoint API bekerja, dan production build selesai tanpa error.

    Setelah melakukan pemeriksaan satu per satu, ternyata masalahnya bukan pada domain, SSL, kode halaman, atau environment variables.

    Masalahnya ada pada cara Next.js menghasilkan paket deployment.

    Solusi yang akhirnya berhasil adalah menambahkan:

    output: "standalone"

    ke dalam konfigurasi Next.js.

    Artikel ini menjelaskan proses diagnosisnya, alasan solusi tersebut bekerja, dan langkah-langkah yang bisa dicoba ketika mengalami masalah serupa.


    Gejala yang Terjadi

    Berikut kondisi deployment pada saat masalah muncul:

    • repository GitHub berhasil terhubung ke Hostinger,
    • framework terdeteksi sebagai Next.js,
    • proses npm install berhasil,
    • proses next build berhasil,
    • tidak ada vulnerability dari npm audit,
    • deployment berstatus Completed,
    • aplikasi berstatus Running,
    • domain dan SSL sudah aktif,
    • tetapi halaman utama tetap menampilkan 403 Forbidden.

    Build log terlihat normal:

    Creating an optimized production build ...
    Compiled successfully
    Generating static pages ...
    Finalizing page optimization ...
    
    Route (app)
    ┌ ○ /
    ├ ○ /_not-found
    └ ƒ /api/health

    Secara sekilas, tidak ada tanda bahwa deployment mengalami kegagalan.


    Memastikan Aplikasi Berjalan di Localhost

    Sebelum mengubah konfigurasi hosting, langkah pertama yang sebaiknya dilakukan adalah memastikan aplikasi memang dapat berjalan dalam mode production di komputer lokal.

    Jalankan:

    npm run build
    npm run start

    Kemudian buka:

    http://127.0.0.1:3000

    Pada kasus saya, halaman utama berhasil ditampilkan.

    Endpoint API juga bekerja:

    http://127.0.0.1:3000/api/health

    Respons yang diterima:

    {
      "status": "ok",
      "runtime": "nextjs",
      "timestamp": "2026-07-30T05:16:50.459Z"
    }

    Hasil ini membuktikan bahwa:

    • source code dapat dikompilasi,
    • Next.js dapat dijalankan dalam mode production,
    • halaman utama bekerja,
    • route dinamis bekerja,
    • masalah kemungkinan berada pada proses packaging atau runtime hosting.

    Build Berhasil Belum Tentu Runtime Berhasil

    Salah satu pelajaran penting dari masalah ini adalah:

    Build yang berhasil tidak selalu berarti aplikasi server-side sudah memiliki runtime yang dapat menerima request.

    Perintah berikut:

    next build

    memang menghasilkan folder .next.

    Namun, folder .next pada konfigurasi default belum tentu menjadi paket deployment mandiri yang dapat langsung dijalankan oleh setiap platform hosting.

    Pada banyak server, aplikasi Next.js default dijalankan menggunakan:

    next start

    Perintah tersebut masih mengandalkan struktur repository, package Next.js, dan dependency yang tersedia dalam environment server.

    Hostinger menyediakan managed Web App Hosting yang menangani build, runtime Node.js, process management, routing, dan integrasi GitHub. Aplikasi Next.js yang menggunakan SSR, API route, atau fitur server-side memerlukan proses Node.js yang terus berjalan.


    Memeriksa Struktur File Deployment

    Langkah diagnosis berikutnya adalah membuka File Manager Hostinger.

    Pada deployment yang bermasalah, struktur root hanya berisi:

    .builds/
    public_html/
    DO_NOT_UPLOAD_HERE

    Tidak ada folder:

    nodejs/

    Di dalam public_html, justru terdapat isi build .next, seperti:

    public_html/
    ├── server/
    ├── static/
    ├── cache/
    ├── build-manifest.json
    ├── routes-manifest.json
    └── file build Next.js lainnya

    File .htaccess yang tersedia juga tidak meneruskan request ke runtime Node.js.

    Isinya hanya berupa perlindungan terhadap folder build:

    RewriteRule ^\.builds - [F,L]

    Artinya, Apache menerima request dari browser, tetapi tidak memiliki aplikasi Node.js yang menjadi tujuan request tersebut.

    Hasilnya adalah 403 Forbidden.


    Membandingkan dengan Deployment Next.js yang Berhasil

    Untuk mencari perbedaannya, saya membandingkan struktur tersebut dengan aplikasi Next.js lain yang berhasil berjalan di akun Hostinger yang sama.

    Deployment yang berhasil memiliki struktur:

    .builds/
    nodejs/
    public_html/

    Di dalam folder nodejs, terdapat:

    nodejs/
    ├── .next/
    ├── node_modules/
    ├── public/
    ├── tmp/
    ├── package.json
    ├── server.js
    ├── console.log
    └── stderr.log

    Sementara itu, public_html hanya berisi .htaccess.

    Isi .htaccess mengarahkan request ke aplikasi Node.js melalui Passenger:

    PassengerAppRoot /home/username/domains/example.com/nodejs
    PassengerAppType node
    PassengerNodejs /path/to/node
    PassengerStartupFile server.js
    PassengerBaseURI /
    PassengerRestartDir /home/username/domains/example.com/nodejs/tmp

    Alur request pada deployment yang benar menjadi:

    Browser
       ↓
    Apache
       ↓
    .htaccess
       ↓
    Passenger
       ↓
    nodejs/server.js
       ↓
    Next.js

    Hostinger juga menjelaskan bahwa build aplikasi backend seperti Next.js ditempatkan di folder nodejs, sedangkan .htaccess di public_html digunakan untuk routing menuju runtime tersebut.


    Akar Masalahnya: Tidak Ada Paket Standalone

    Setelah membuka server.js dari deployment yang berhasil, ditemukan konfigurasi berikut:

    "output": "standalone"

    Di sinilah penyebab utama ditemukan.

    Repository yang mengalami 403 belum menggunakan:

    output: "standalone"

    Akibatnya, Next.js hanya menghasilkan output build default dan Hostinger tidak memperoleh paket runtime mandiri yang berisi server.js.

    Tanpa server.js, Hostinger tidak membentuk struktur runtime yang seharusnya digunakan Passenger untuk menjalankan aplikasi.


    Solusi: Aktifkan Next.js Standalone Output

    Buat atau edit file next.config.mjs di root repository:

    /** @type {import("next").NextConfig} */
    const nextConfig = {
      output: "standalone",
    };
    
    export default nextConfig;

    Struktur sederhananya:

    project/
    ├── app/
    ├── package.json
    ├── package-lock.json
    └── next.config.mjs

    Apabila menggunakan format CommonJS pada next.config.js, bentuknya dapat ditulis sebagai:

    /** @type {import("next").NextConfig} */
    const nextConfig = {
      output: "standalone",
    };
    
    module.exports = nextConfig;

    Gunakan salah satu format yang sesuai dengan repository. Tidak perlu membuat keduanya.


    Apa yang Dilakukan output: "standalone"?

    Ketika konfigurasi standalone aktif, Next.js melakukan output file tracing.

    Next.js menganalisis file, import, dependency, dan package yang benar-benar dibutuhkan aplikasi saat production. Kemudian Next.js menghasilkan paket runtime minimal di:

    .next/standalone/

    Strukturnya kurang lebih:

    .next/
    └── standalone/
        ├── server.js
        ├── package.json
        ├── node_modules/
        └── .next/

    File server.js tersebut dibuat otomatis oleh Next.js. Kita tidak perlu menulis custom server sendiri.

    Next.js menjelaskan bahwa standalone output membuat folder deployment berisi file yang diperlukan, dependency terpilih, serta server minimal yang dapat dijalankan tanpa menggunakan next start.


    Menguji Standalone Output di Localhost

    Setelah menambahkan konfigurasi, hapus hasil build lama dan jalankan build ulang:

    rm -rf .next
    npm run build

    Periksa apakah file berikut sudah terbentuk:

    test -f .next/standalone/server.js
    test -f .next/standalone/package.json
    test -d .next/standalone/node_modules

    Jalankan standalone server:

    PORT=3001 \
    HOSTNAME=127.0.0.1 \
    node .next/standalone/server.js

    Kemudian buka:

    http://127.0.0.1:3001

    Pada kasus saya, halaman utama berhasil mengembalikan HTTP 200 dan endpoint API bekerja normal.

    Catatan tentang file statis

    Dokumentasi Next.js menyebutkan bahwa folder public dan .next/static tidak otomatis disalin ke folder standalone. Platform deployment dapat menangani proses tersebut sendiri. Untuk deployment manual, keduanya dapat disalin ke:

    .next/standalone/public
    .next/standalone/.next/static

    Push ke GitHub dan Biarkan Hostinger Melakukan Deployment Ulang

    Setelah standalone berhasil diuji secara lokal:

    git add next.config.mjs
    git commit -m "fix(deploy): enable Next.js standalone output"
    git push origin main

    Apabila auto-deployment Hostinger aktif, push ke branch yang terhubung akan memicu deployment baru secara otomatis.

    Pastikan build log kembali berhasil:

    Compiled successfully
    Generating static pages
    Finalizing page optimization

    Setelah deployment selesai, buka domain.

    Pada kasus saya, halaman yang sebelumnya menampilkan:

    403 Forbidden

    akhirnya berubah menjadi halaman Next.js yang benar.

    Endpoint dinamis juga berhasil diakses:

    https://example.com/api/health

    Responsnya:

    {
      "status": "ok",
      "runtime": "nextjs"
    }

    Struktur Deployment Setelah Berhasil

    Setelah standalone output diterapkan, Hostinger membentuk struktur yang lebih tepat:

    .builds/
    nodejs/
    public_html/

    Folder nodejs berisi:

    nodejs/
    ├── .next/
    ├── node_modules/
    ├── package.json
    ├── server.js
    └── file runtime lainnya

    Sementara itu, public_html/.htaccess meneruskan request ke nodejs/server.js melalui Passenger.

    Dengan demikian, request tidak lagi berhenti di Apache dan dapat diproses oleh Next.js.


    Mengapa Redeploy Saja Tidak Menyelesaikan Masalah?

    Sebelum menemukan akar masalah, saya sempat melakukan redeploy tanpa mengubah kode.

    Build kembali berhasil, tetapi website tetap 403.

    Hal ini terjadi karena redeploy hanya membangun ulang konfigurasi repository yang sama.

    Selama repository belum menghasilkan standalone runtime, hasil deployment tetap tidak memiliki server.js yang dibutuhkan.

    Jadi, urutannya bukan hanya:

    Redeploy

    melainkan:

    Tambahkan output: "standalone"
    ↓
    Build dan uji lokal
    ↓
    Commit
    ↓
    Push
    ↓
    Deploy ulang

    Dokumentasi Hostinger menyatakan redeployment dapat membuat ulang .htaccess, tetapi apabila paket aplikasi yang dibutuhkan belum terbentuk, regenerasi routing saja belum tentu menyelesaikan penyebab dasarnya.


    Checklist Troubleshooting 403 Next.js di Hostinger

    Ketika mengalami masalah serupa, gunakan checklist berikut.

    1. Pastikan aplikasi berjalan lokal

    npm run build
    npm run start

    2. Pastikan route utama mengembalikan HTTP 200

    curl -I http://127.0.0.1:3000

    3. Periksa build log Hostinger

    Pastikan tidak ada:

    Build failed
    Module not found
    Environment variable missing
    Out of memory

    4. Periksa struktur file Hostinger

    Deployment server-side yang benar seharusnya memiliki:

    nodejs/
    public_html/.htaccess

    5. Periksa apakah server.js tersedia

    nodejs/server.js

    6. Tambahkan standalone output

    const nextConfig = {
      output: "standalone",
    };

    7. Pastikan artefak lokal terbentuk

    .next/standalone/server.js

    8. Push dan deploy ulang

    git push origin main

    9. Uji halaman dan endpoint dinamis

    https://example.com/
    https://example.com/api/health

    10. Jangan langsung mengedit .htaccess secara manual

    Pada managed Web App Hosting, .htaccess dan konfigurasi Passenger sebaiknya dihasilkan oleh platform deployment.

    Edit manual dapat hilang ketika deployment berikutnya dijalankan.


    Apakah Semua Proyek Next.js Harus Menggunakan Standalone?

    Tidak selalu.

    Output default Next.js tetap valid dan dapat dijalankan menggunakan:

    next build
    next start

    pada server atau platform yang memang dikonfigurasi untuk menjalankan struktur repository secara penuh.

    Standalone lebih relevan ketika aplikasi perlu dikemas menjadi paket runtime yang:

    • lebih portabel,
    • memiliki server.js,
    • hanya membawa dependency yang dibutuhkan,
    • dijalankan oleh container, Passenger, atau platform deployment tertentu,
    • tidak bergantung pada seluruh repository production.

    Jadi, output: "standalone" bukan pengganti semua metode deployment.

    Namun, untuk kasus Hostinger Web App dengan gejala build berhasil tetapi domain 403 dan folder nodejs tidak terbentuk, konfigurasi ini layak menjadi pemeriksaan utama.


    Standalone Bukan Static Export

    Perlu dibedakan antara:

    output: "standalone"

    dan:

    output: "export"

    standalone tetap menjalankan server Node.js.

    Fitur seperti berikut tetap dapat digunakan:

    • server-side rendering,
    • Route Handlers,
    • API endpoint,
    • Server Components,
    • autentikasi server-side,
    • koneksi database,
    • halaman dinamis.

    Sementara output: "export" menghasilkan website statis tanpa runtime Node.js.

    Apabila aplikasi menggunakan API route atau fitur backend Next.js, jangan mengganti standalone dengan static export hanya untuk menghindari masalah runtime.


    Kesimpulan

    Masalah 403 pada deployment Next.js di Hostinger dapat terlihat seperti masalah domain, permission, SSL, atau .htaccess.

    Namun, pada kasus yang saya alami, akar masalahnya adalah aplikasi belum menghasilkan paket runtime standalone.

    Build memang berhasil, tetapi Hostinger tidak memperoleh:

    server.js

    yang diperlukan untuk menjalankan Next.js melalui Passenger.

    Solusinya adalah menambahkan:

    const nextConfig = {
      output: "standalone",
    };

    Setelah build ulang, pengujian lokal, commit, dan deployment baru, Hostinger berhasil membentuk runtime Node.js dan website dapat diakses secara normal.

    Ringkasnya:

    Build sukses + website 403
    ↓
    Periksa folder nodejs dan server.js
    ↓
    Tambahkan output: "standalone"
    ↓
    Build dan uji lokal
    ↓
    Deploy ulang
    ↓
    Website berhasil diakses

    Semoga pengalaman ini membantu pengguna Hostinger lain yang mengalami kondisi serupa.

    Keywords : Next.js output standalone, deploy Next.js ke Hostinger, Hostinger Web App, Next.js server.js, Next.js Passenger, error 403 Hostinger

  • Cara Mengatasi Masalah Login “Nextend Social Login” WordPress

    Cara Mengatasi Masalah Login “Nextend Social Login” WordPress

    Kronologi

    Saya punya website membership, dimana ada masalah penamaan pada domainnya, sehingga mengharuskan saya mengganti nama domain tersebut dengan nama lain. Singkat cerita, akhirnya nemu nama domain yang cocok, saya beli, dan tibalah ditahap migrasi website dari domain lama ke domain baru. Proses migrasi berjalan lancar, tanpa error sedikitpun. Namun ada satu masalah kecil, tapi fatal.

    Masalah

    Dimana, saat saya coba login dengan user lama di website lama, datanya tidak akurat. Misal saya login dengan email : emailsatu@gmail.com jika di cek lewat fungsi “wp_get_current_user();” maka yang muncul justru akun/email member lainnya misal : memberdua@gmail.com 😅 Kan kacau ya!

    Dan kadang untuk akun-akun tertentu, login manual berhasil, tetapi login via Google kadang masuk ke akun yang salah, bahkan muncul pesan, “We found a user with your Google email address, it belongs to a different account.”

    Solusi

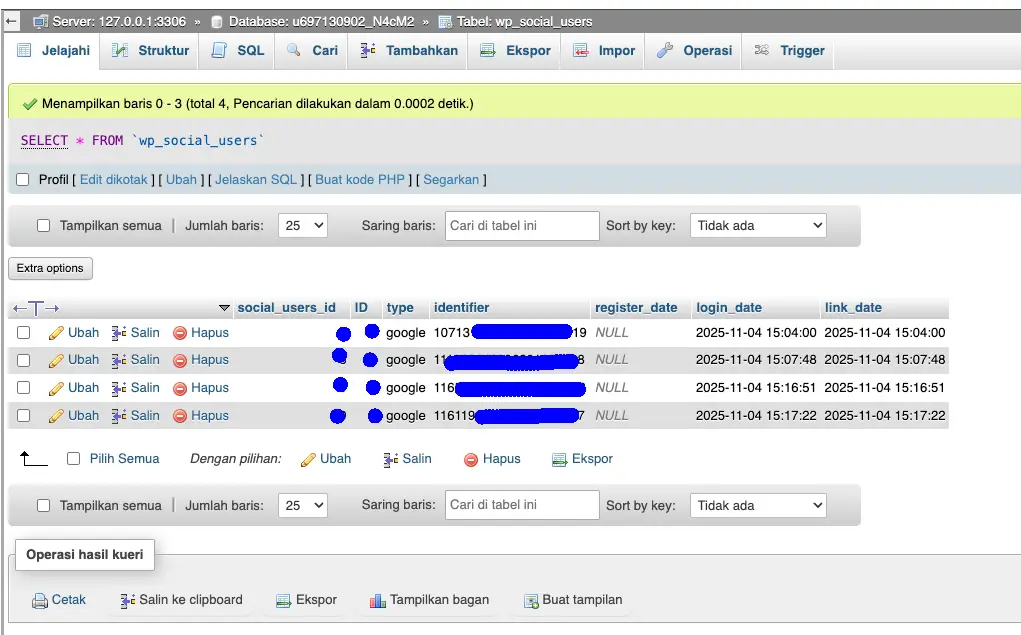
    Setelah bolak balik cek konfigurasi, solusinya ternyata sederhana, yaitu hapus isi tabel wp_social_users yang menjadi sisa dari plugin social login lama, dan masalah selesai.

    Sorry agak singkat, lagi capek banget! tapi yang penting intinya hapus isi tabel wp_social_users

    Semoga berhasil!

  • Cara Menonaktifkan Cache Saat Ngoding Di Server Langsung

    Cara Menonaktifkan Cache Saat Ngoding Di Server Langsung

    Konteks

    Dulu waktu awal awal belajar ngoding di kampus, rata-rata pasti diajarinnya ngoding di localhost. Dengan cara bikin server virtual di laptop/PC. Tapi kalau di dunia kerja, sebagian project harus dikerjakan secara live di web servernya, dengan mengakses domain/alamat websitenya langsung.

    Makin kesini, teknologi di server juga makin canggih, salah satunya di sisi efisiensi penggunaan bandwidth. Salah satu yang berperan penting disini adalah sistem Cache

    Dengan sistem cache, website kita bisa akses dengan cepat (ringan) oleh user, karena saat user membuka pertama kali, seluruh elemen website kita (code, css, script, gambar, dll) akan disalin, dan disimpan sementara di server server terdekat dengan pengguna. Dan disimpan juga di browser kita. Dan saat user mengakses lagi, seluruh elemen tidak di load ulang lagi dari awal.

    Kalau yang mengakses user/pengguna website sih ini jadi sangat menguntungkan, karena performa website kita terkesan cepat. Tetapi ini jadi masalah untuk kita yang lagi mengembangkan websitenya.

    Kronologi

    Saat kita melakukan perubahan kode atau konten di website, maka perubahan tersebut tidak bisa langsung terlihat. Karena yang kita akses adalah Cache nya (kondisi halaman sebelumnya).

    Bagi kamu yang berlangganan di web hosting seperti Hostinger contohnya, selain menerapkan Cache browser, disini juga menerapkan Cache server. Sehingga sekeras apapun usahamu menghapus Cache di browser, tidak akan ada pengaruhnya. Tetap saja perubahan code atau konten, yang kamu lakukan di server tidak bisa terlihat di browser kamu.

    Cara Menonaktifkan Cache Secara Permanen Di Server.

    Jawabannya ada pada CDN (Content Delivery Network), adalah jaringan server yang tersebar secara global untuk mengirimkan konten web. CDN menyimpan konten yang di-cache di server edge yang dekat dengan pengguna

    Login ke akun webhosting kami (disini saya langganan di hostinger)

    Lalu pilih website yang ingin kamu manage, setelah sampai di halaman dibawah ini, lakukan pengaturan berikut :

    1. Pilih domain / nama website yang ingin kamu atur Cache nya.

    2. Ketik CDN di kolom pencarian

    Lalu klik tombol Nonaktifkan

    Dan setelah itu, kamu bisa mengubah code dan konten apapun di halaman website, dan perubahannya langsung bisa terlihat di browser.

  • Membuat HTML Select Tag Element Agar Ada Search Box nya

    Membuat HTML Select Tag Element Agar Ada Search Box nya

    Kronologi

    Ini agar receh sebenernya, tapi bagi programmer pemula pasti sangat bermanfaat. Seperti yang kita tau, salah satu tugas programmer bukan hanya sekedar jago bikin program, tapi juga bagaimana membuat user mudah menggunakan aplikasi, yang sedang kita kembangkan.

    Salah satu cara mempermudah user dalam menggunakan aplikasi kita adalah, membuat select tag element agar bisa di search, tidak sekedar muncul drop down saat di klik, tapi juga bisa di search atau di ketik untuk mencari data yang muncul pada select element tersebut.

    Contoh select tag yang simpel

    <select class="form-select">
      <option selected>Pilih...</option>
      <option value="1">Pilihan Satu</option>
      <option value="2">Pilihan Dua</option>
      <option value="3">Pilihan Tiga</option>
    </select>

    Masalah

    Kalau pilihannya cuman 3 sih nggak masalah pakai cara ini, tapi kalau pilihannya dinamis, isinya puluhan, ratusan atau bahkan ribuan gimana?

    Bisa-bisa user mabok, memilih salah satu data, dari sekian banyak pilihan yang tampil.

    Solusi

    Sebetulnya ada banyak cara, tapi ini salah satu cara yang belakangan ini sering saya pakai, untuk membuat search pada select element. Yaitu dengan Selectize berbasis jQuery.

    1. Load semua komponen Selectize

    <!-- Load CSS nya -->
    <link rel="stylesheet" href="https://cdnjs.cloudflare.com/ajax/libs/selectize.js/0.12.6/css/selectize.bootstrap3.min.css" integrity="sha256-ze/OEYGcFbPRmvCnrSeKbRTtjG4vGLHXgOqsyLFTRjg=" crossorigin="anonymous" />
    
    <!-- Load jquery nya -->
    <script src="https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js"></script>
    
    <!-- Load Javascript Selectize -->
    <script src="https://cdnjs.cloudflare.com/ajax/libs/selectize.js/0.12.6/js/standalone/selectize.min.js" integrity="sha256-+C0A5Ilqmu4QcSPxrlGpaZxJ04VjsRjKu+G82kl5UJk=" crossorigin="anonymous"></script>

    2. Siapkan select elementnya

    Pertama siapkan file koneksi.php

    <?php
    $dbhost = "localhost"; 
    $dbuser = "xxx";     // isi user name database kamu
    $dbpass = "xxx";     // ini password database kamu
    $dbname = "xxx";     // ini nama database kamu
    
    // melakukan koneksi ke database
    $connect = new mysqli($dbhost,$dbuser,$dbpass,$dbname);
    
    mysqli_set_charset($connect,"utf8");
    
    // cek koneksi yang kita lakukan berhasil atau tidak
    if ($connect->connect_error) {
       // jika terjadi error, matikan proses dengan die() atau exit();
       die('Maaf koneksi gagal: '. $connect->connect_error);
    }

    Lalu, siapkan element selectnya. Saya asumsikan kalian sudah punya database dan tabel yang ingin di olah ya.

    <label class="form-label">Nama Produk</label>							  				
    <select placeholder="Ketik nama produk..." name="id_produk" id="id_produk">
    	<option value="" selected>Ketik nama produk...</option>
    	<?php
    	include "koneksi.php";    
    	$query = "SELECT * FROM tb_produk";
    	$hasil = mysqli_query($connect, $query) or die("Gagal terhubung ke database " . mysqli_error($connect));
    	while($data=mysqli_fetch_array($hasil)){
    		echo "<option value=$data[id_produk]>$data[nama_produk]</option>";
    	}
    	?>
    </select>

    Kita juga perlu mendefinisikan, bahwa si Selectize ini akan hanya berefek pada select tag yang memiliki ID atau Nama tertentu, dalam contoh ini adalah “id_produk”. Ini penting agar tidak berpengaruh ke select tag lainnya, yang tidak memerlukan tritmen seperti ini.

    <script type="text/javascript">
    	$(document).ready(function () {
    		$('#id_produk').selectize({
    			sortField: 'text'
    		});
    	});
    </script>

    Semoga bermanfaat ya. Kalau ada yang ingin ditanyakan, bisa DM saya di sosmed.

    Lihat contoh hasilnya

  • Cara Ambil Nilai Element HTML Select, Bukan Value, Tapi Textnya

    Cara Ambil Nilai Element HTML Select, Bukan Value, Tapi Textnya

    Kronologi

    Saya sedang ngerjain project ERP (Enterprise Resource Planning), dan menemukan kasus unik, dimana pada fitur yang sedang saya buat kali ini, mengharuskan saya mengambil nilai dari element select. Bukan isi valuenya, tetapi isi text yang dipilih. Contohnya begini.

    Dibawah ini, ada sebuah elemen select, dengan 3 pilihan. Nah perhatikan di bagian valuenya. Contoh untuk Pcs, disana valuenya 4000. Pcs mewakili satuannya, sedangkan 4000 mewakili harganya.

    Jadi untuk produk ini, per pcsnya, harganya 4000. dan untuk satuan Bal, harga per bal nya 12000, terakhir, 1 Box harganya 40000.

    <label for="satuanProduk">Satuan Produk:</label>
    <select id="satuanProduk">
      <option value="4000">Pcs</option>
      <option value="12000">Bal</option>
      <option value="40000">Box</option>
    </select>

    Masalah

    Nah kalau dengan sistem penyeimpanan normal, menggunakan metode $_POST di php. Jika dari 3 opsi, kita pilih satuannya.

      <option value="4000">Pcs</option>

    Misalnya adalah Pcs, maka saat kita simpan, nilai yang kita dapatkan adalah sesuai isi dari valuenya, yaitu 4000, bukan Pcs.

    Nah sampai saat ini saya belum tau cara mendapatkan nilai textnya yaitu “Pcs”. Dengan perintah php standar.

    Solusi

    Dari pada makin botak, saya akali dengan Javascript aja dengan membuat satu input baru bernama “mirror”, yang fungsinya memirroring atau menangkap nilai dari text si <select> satuanProduk secara realtime, saat ada perubahan di select satuanProduk, akan langsung di kirim isi textnya ke input mirror.

    Nanti hasil mirroring dari input “mirror” inilah yang saya simpan. Bukan nilai dari si <select> satuanProduk ini. Tapi si input “mirror” ini saya hide (dengan type=”hidden”), agar tidak mengganggu estetika.

    Jadi contoh penerapannya seperti ini.

    <!DOCTYPE html>
    <html lang="en">
    <head>
        <meta charset="UTF-8">
        <meta name="viewport" content="width=device-width, initial-scale=1.0">
        <title>Real-time Mirror</title>
    </head>
    <body>
        <label for="satuanProduk">Satuan Produk:</label>
        <select id="satuanProduk" onchange="updateMirror()">
            <option value="4000">Pcs</option>
            <option value="12000">Bal</option>
            <option value="40000">Box</option>
            <!-- Tambahkan opsi lain jika diperlukan -->
        </select>
        <br>
        <label for="mirror">Mirror:</label>
        <input type="text" id="mirror" readonly>
        <script>
            function updateMirror() {
                // Mengambil elemen select berdasarkan id
                var selectSatuanProduk = document.getElementById("satuanProduk");
    
                // Mengambil nilai teks yang dipilih pada select
                var nilaiTeksPilihan = selectSatuanProduk.options[selectSatuanProduk.selectedIndex].text;
    
                // Mengambil elemen input mirror berdasarkan id
                var inputMirror = document.getElementById("mirror");
    
                // Menetapkan nilai input mirror dengan nilai teks yang dipilih pada select
                inputMirror.value = nilaiTeksPilihan;
            }
        </script>
    </body>
    </html>

    Lihat demonya disini

  • Solusi Website Error : “Your Connection is Not Secure” di Chrome

    Solusi Website Error : “Your Connection is Not Secure” di Chrome

    Kronologi

    Saya ijin cerita dulu kronologinya seperti apa. Jadi sejak 2017, saya menggunakan layanan domain dan hosting dari Hostinger. Semenjak pindah ke Hostinger saya sangat jarang menemukan masalah-masalah teknis, bener-bener sangat sangat jarang. Kalaupun terjadi, pasti karena adanya maintenance pada server, itupun ada pemberitahuan terlebih dahulu.

    Nah kali ini tumben banget, saya nemukan masalah, adanya error pada SSL dengan pesan “Your Connection is Not Secure”.

    Nah kebetulan saya lagi ngerjain project, bikin sistem ERP (Enterprise Resource Planning) di perusahaan produsen kue dan roti. Jadi sistem ini nantinya mengelola database perusahaan mulai dari modul produksi, penjualan, akuntansi, asset, HR atau karyawan, dll.

    Masalah

    Tiap kali bikin sistem seperti ini, saya selalu “tumpangin” sistemnya di sub domain website perusahan tersebut. Kalau domain utamanya sih SSL nya bekerja normal, tidak ada error seperti ini. Erorr ini cuman muncul di subdomainnya aja.

    Saat “Not Secure” di klik, maka akan muncul detil seperti ini.

    Solusi

    Saya sudah coba googling sana sini, solusi-solusinya itu sangat beragam. Dan sejujurnya agak susah di ikutin. Tapi tadi saya iseng googling lagi, dan nemu tutorial “Cara Mengatasi Your Connection is Not Secure di Chrome” oleh website resmi dari Hostinger.

    Ternyata untuk pelanggan Hostinger, solusinya itu gampang banget. Cukup uninstall dan install ulang SLLnya.

    Caranya gini.

    1. Login ke Hpanel Hostinger kamu https://hpanel.hostinger.com

    2. Pada menu “Website”, pilih website yang SSLnya sedang bermasalah

    3. Pilih menu “Keamanan” lalu pilih “SSL”

    4. Uninstall domain/subdomain yang bermasalah, dengan klik titik tiga di sudut kanan. pilih “Uninstall”.

    5. Install ulang domain/subdomain yang sudah di hapus tadi, dengan cara mengetikan nama domain/subdomain di atas, lalu klik tombol Install SSL

    Tunggu beberapa saat, maka nanti saat kamu akses kembali domain/subdomainnya, error SSL “Not Secure” atau “Your Connection is Not Secure” bakalan hilang.

  • Begini Cara Merapikan Kodingan Secara Otomatis Di Sublime Text

    Begini Cara Merapikan Kodingan Secara Otomatis Di Sublime Text

    Jadi programmer itu, nggak cuman sekedar bisa ngoding, nggak sekedar tentang aplikasinya bisa jalan. Tapi jadi programmer itu, juga harus bisa ngoding dengan rapi. Di kantor saya dulu, temen programmer yang kodingannya berantakan, selalu kena bully, kita katain “programmer jorok”.

    Walaupun client nggak bakal pernah tau isi kodingan kita, tapi suatu saat, fitur yang dikerjain si “programmer jorok” ini bisa jadi bakal dikembangkan oleh programmer lain. Wah nggak enak banget kan, dapet tugas benerin fitur yang kodingannya jorok?

    Nah bagi kamu yang kodingannya masih jorok, atau kamu yang lagi dapet tugas benerin fitur yang kodingannya jorok, coba pakai cara ini.

    1. Download Sublime

    Akses halaman resmi Sublime Text, dan download disini dan pilih versi OS yang kamu pakai. Windows atau Mac. 100% GRATIS!

    2. Lakukan pengaturan

    Buka aplikasi sublime yang sudah kamu install. Lalu masuk ke menu Tools –> Command Palette. Lalu ketik “Install package control“. Klik yang paling atas. “Package control: Install Package”

    Lalu ketik “reindent on save”, lalu klik. Maka akan otomatis terinstall.

    3. Buka file kodingannya pakai Sublime

    Nah karena saya ngodingnya udah kebiasaan rapi dari dulu 😜, jadi saya coba pepetin codingannya ke kiri semua dulu ya. Anggap aja ini contoh kodingan yang nggak rapi.

    a. Sebelum

    Untuk merapikan, cukup tinggal di CTRL + S (Kalau di mac Command + S). Setelah itu kodingan kamu bakal otomatis merapikan dirinya sendiri seperti dibawah ini.

    b. Sesudah

    Sejorok apapun kodingan kamu, kalau udah kena CTRL + S (Win) atau Command + S (Mac). Langsung auto rapih.

  • Jumlah Pengunjung Web Drop/Turun Drastis Setelah Saya Melakukan Ini

    Jumlah Pengunjung Web Drop/Turun Drastis Setelah Saya Melakukan Ini

    Jumlah pengunjung web saya, turun/drop tiba-tiba secara signifikan, setelah saya melakukan hal ini. Lalu sebenernya apa sih penyebabnya?

    Kronologi

    Salah satu website milik saya, yang sudah dikenlola sekitar hampir 2 Tahunan ini, dari awal dibangun, menunjukan pertumbuhan yang positif, dimana trafik atau pengunjung websitenya, berangsur-angsur naik. Walaupun kenaikan perhariinya sangat sedikit, tapi jumlahnya selalu meningkat dari waktu-kewaktu.

    Awal bulan November 2023 kemarin, saya menyusun sebuah strategi SEO untuk website (nantinya bisa diterapkan ke website manapun). Dan sayapun sudah tau, bahwa ini sangat beresiko. Tapi kalau tidak dicoba, saya tidak akan pernah tau, apakah ini akan berhasil atau tidak. Karena berhasil atau enggaknya, tergantung apakah ini terdeteksi pelanggaran atau tidak oleh algoritma google.

    Kalau terdeteksi pelanggaran, ya sudah! habislah sudah. Perjuangan saya ngembangin website ini selama 2 tahun akan sia-sia, karena website bisa saja di banned/blokir oleh Google.

    Tapi bagaimana kalau tidak? ternyata rencana ini berjalan dengan lancar. Maka saya yakin, webiste ini bakal naik banget jumlah pengunjungnya, secara signifikan. Karena menurut teori saya, cara ini bisa digunakan untuk “memanipulasi” Google crawl, saat merayapi halaman website kita.

    Saat orang-orang mengetikan kata kunci di google, seakan-akan website kita ini, menyediakan informasi yang paling lengkap. Sehingga algoritma google, mengangkat artikel kita ini, sebagai rangking 1. Atau minimal, di halaman 1, hasil pencarian google.

    Biar engga cuman jadi rencana belaka, akhirnya tepat pada tanggal 13 November 2023, saya mulai praktek!, dengan menerapkan metode ini, di salah satu website saya.

    Secara garis besar, strateginya seperti ini :

    Pada contoh kasus kali ini, kita akan membidik satu kata kunci, yaitu “Nyeri Ulu Hati”. Untuk memulainya, kita membuat blog post baru berjudul “Nyeri Ulu Hati”. Jangan tambahkan apa apa, nanti untuk meta Judul SEO nya, kita otak atik di plugin yoast SEO (judul yang tampil di hasil pencarian).

    1. Buat Blog Post baru berjudul “Nyeri Ulu Hati”

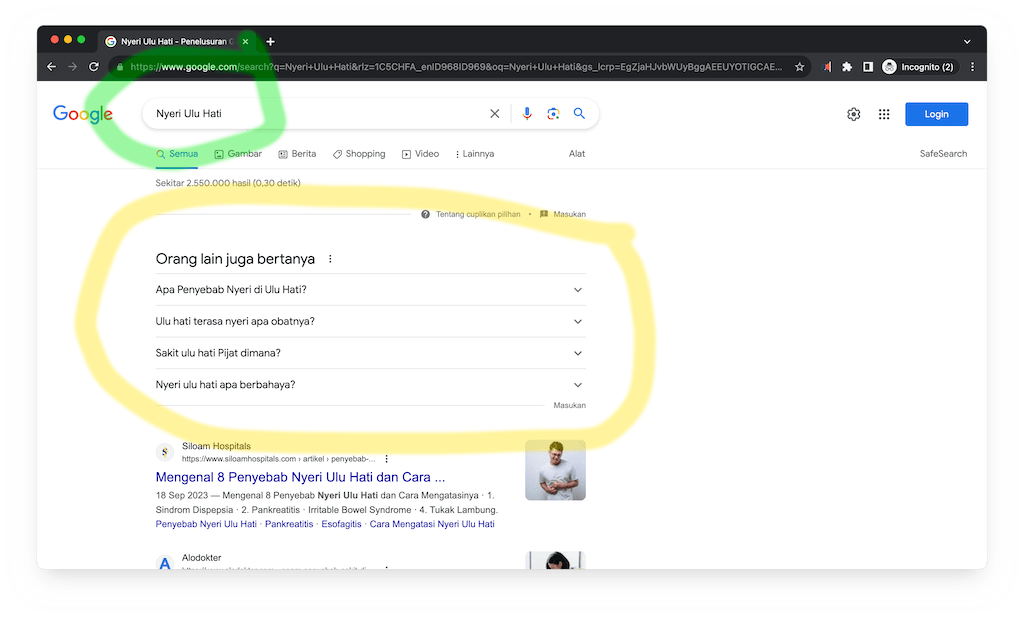
    2. Buka google.com, Ketik kata kunci “Nyeri Ulu Hati”, lalu enter. Maka akan tampil hasil pencarian.

    3. Cek dibawahnya, biasanya akan ada bagian “Orang lain juga bertanya”. Seperti yang kita lihat di gambar dibawah, ada 4 baris. Nah lalu salin ke 4 pertanyaan itu ke texteditor atau notepad atau semacamnya. Selanjutnya, hal ini kita sebut dengan istilah “Pertanyaan Umum”.

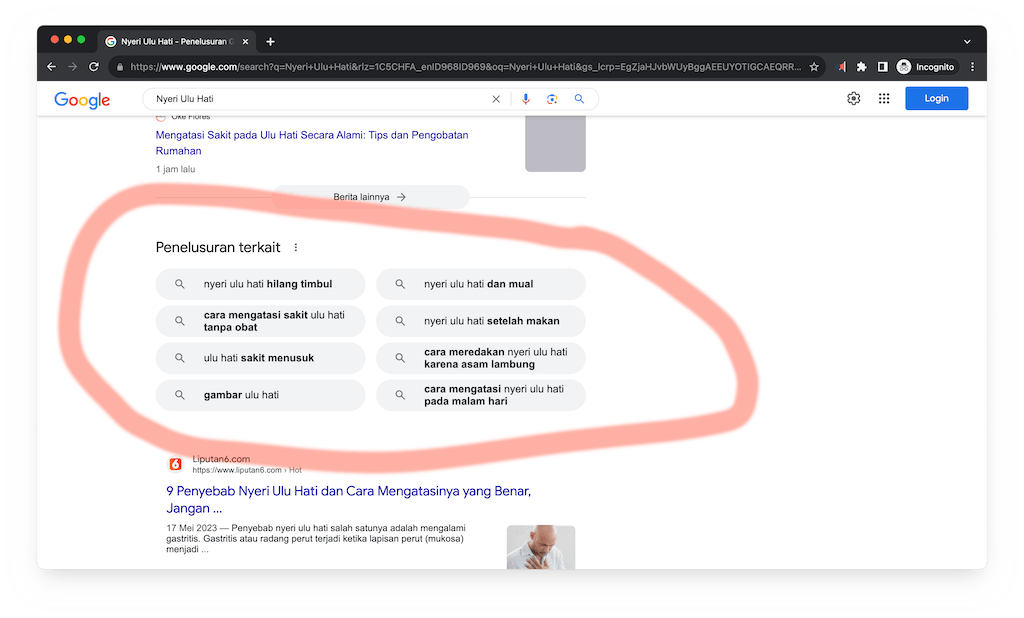
    4. Dari hasil pencarian tadi, scroll lagi kebawah, nanti kamu akan menemukan “Penelusuran terkait”. Seperti yang tampil di gambar dibawah, salin ke 8 kata kunci itu. pindah ke texteditor atau notepad atau semacamnya. Selanjutnya kita sebut ini dengan istilah “Judul sub artikel”.

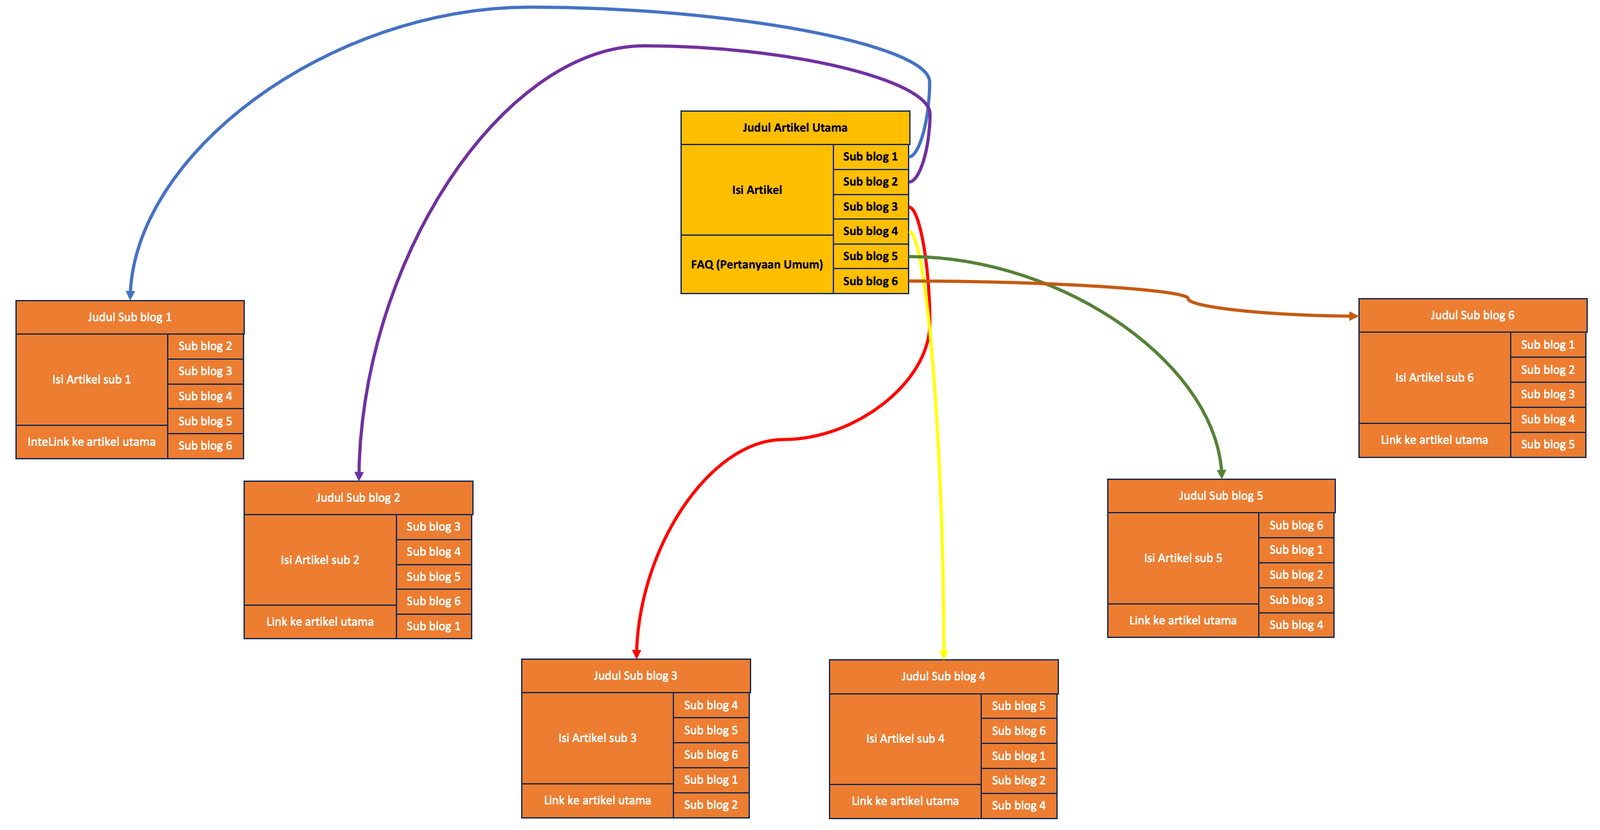
    5. Di artikel utama yang berjudul “Nyeri Ulu Hati” tadi, setelah kita tulis isi artikelnya, dibagian bawah kita sematkan semua “Pertanyaan umum” pada point 3 diatas, beserta jawaban singkatnya. Contohnya seperti ini.

    6. Sedangkan hasil “Penelusuran terkait” pada point 4, kita gunakan sebagai judul artikel juga, yang akan menjadi sub artikel utama.

    7. Di tiap halaman sub artikel, selain menulis isi artikelnya (berdasarkan sub judul artikel), kita juga referensikan, atau sematkan link artikel utama. Contoh seperti gambar dibawah ini. Semua sub artikel, kita sematkan link artikel utama.

    Jadi, kalau kita petakan, 1 artikel akan memiliki banyak sub artikel. Dan tiap sub artikel, akan mereferensikan atau menyematkan link artikel utama.

    Nah sebetulnya, ini baru permukaannya saja, banyak hal detil yang tidak bisa saya jelaskan di sini, karena nanti kepanjangan. Intinya secara garis besar, strateginya seperti ini.

    Dengan menerapkan strategi ini, tiap hari saya harus menulis rata-rata sekitar 9 artikel baru. 1 Artikel utama, sisanya adalah sub artikel.

    8. Nah tahap terakhir, setelah nge post artikel baru, tentu kita harus melakukan index artikel baru tadi di Google Search Console.

    Kabar buruk

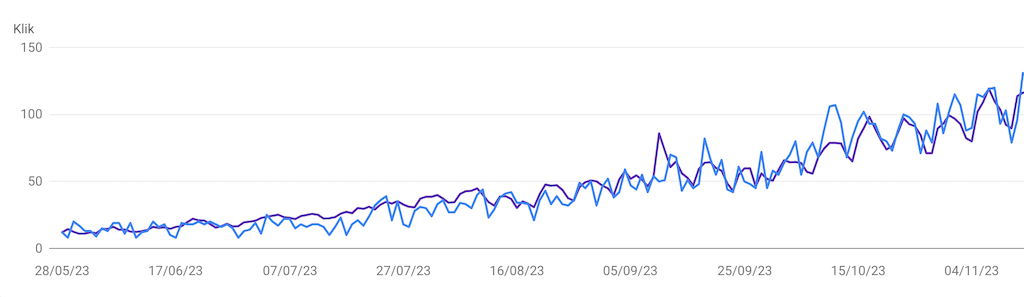
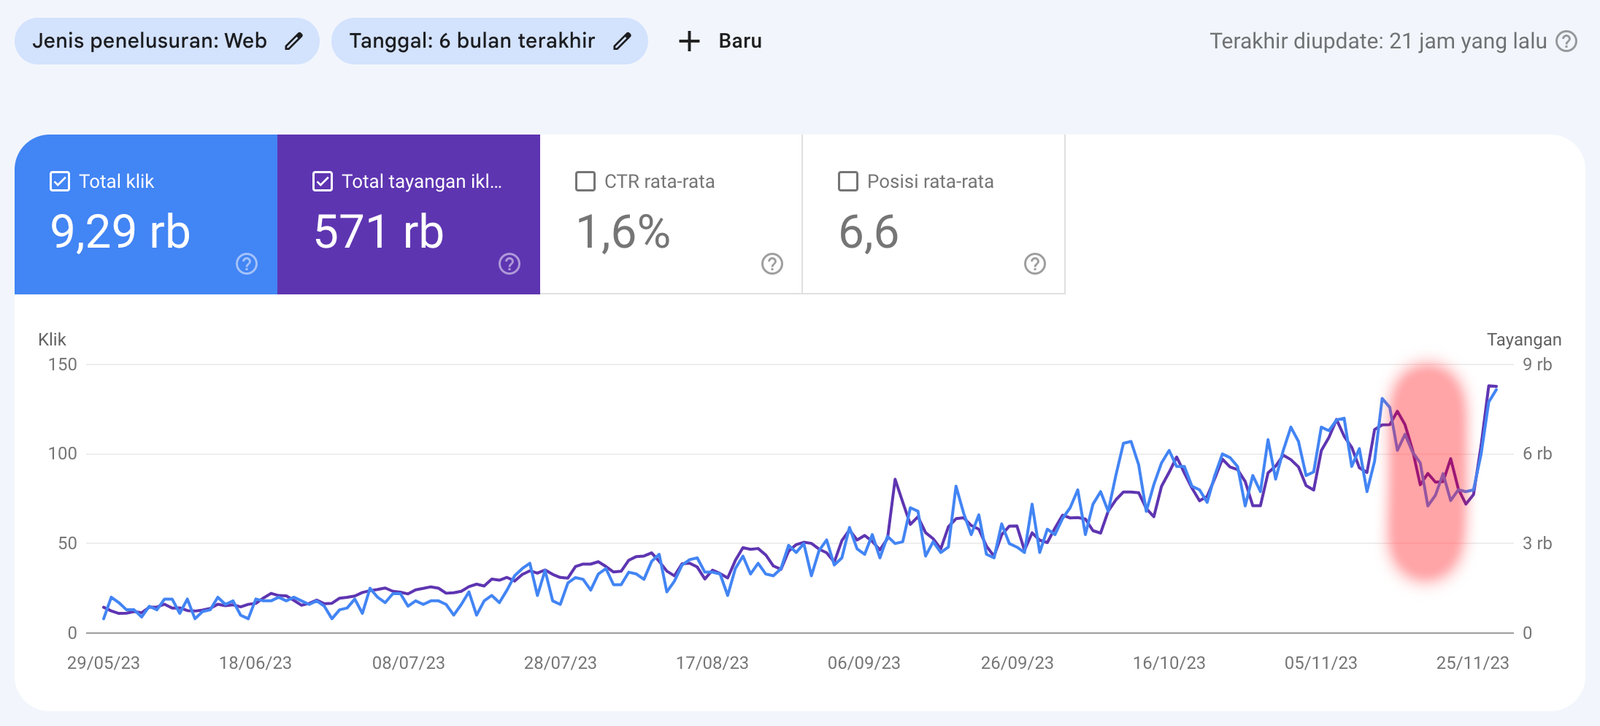
    Nah, sekitar 8 hari, saya menjalankan strategi ini, dari step 1 ke step 8. benar-benar konsisten nge-post 9 artikel baru tiap harinya. Memang tiap hari saya perhatikan ada penurunan, tapi kalau di Google Search Console, memang wajar jika ada penurunan sedikit, tapi setelah setiap hari saya pantau, dari tanggal 13 November 2023, sampai 20 November 2023 (8 hari) trafik atau pengunjung webnya selalu bergerak turun, nggak pernah ada tanda-tanda kenaikan (yang ditandai merah).

    Di hari ke 8, akhirnya saya memutuskan untuk tidak melanjutkan strategi ini. Dengan kata lain, dari tanggal 13 – 20 November 2023 (total 8 hari), dimana artikel yang sudah saya post adalah 72 artikel. Ternyata bukannya menaikan jumlah pengunjung, melainkan membuat jumlah pengunjung website jadi turun drastis/drop. Akhirnya saya berasumsi, bahwa strategi ini terdeteksi sebagai pelanggaran oleh algoritma google.

    Catatan : saya sudah pastikan tidak ada masalah di hal-hal lain, seperti performa, masalah pengindexan, link yang bermasalah, dll. Semua aman, semua sehat, tidak ada indikasi masalah apa apa, pada websitenya.

    Dititik ini, saya lebih banyak bengang-bengong, sambil mikirin solusi untuk mengatasi kekacauan yang saya ciptakan sendiri ini 😁

    Selama bengang-bengong, website ini benar-benar tidak saya sentuh sama sekali. Saya menyibukan diri dengan project saya yang lain.

    Kabar baik

    Setelah 8 hari saya biarkan begitu saja, tanpa menyentuhnya sama sekali, hari ini (Tanggal 30 November 2023) saya cek di Google Search Console, trafiknya naik secara signifikan. Melampaui jumlah sebelum-sebelumnya (rekor baru). dari yang sebelumyna, drop parah (tanda merah).

    Apa yang sedang terjadi? saya juga engga tau! 😂

    Kesimpulan

    Tentu saya belum bisa memberikan kesimpulan utuh ya, karena saya juga tidak tau apa yang terjadi hari hari berikutnya. Tapi sementara ini yang bisa saya simpulkan adalah. Bahwa strategi ini aman, dan saya coba cari tau apa yang menyebabkan pengunjung web kemarin, turun drastis. Nanti pasti saya update lagi kalau ada perkembangan terbaru.

  • Solusi : Cara Mengatasi Error Google Search Console “Gagal: Beban host terlampaui”

    Solusi : Cara Mengatasi Error Google Search Console “Gagal: Beban host terlampaui”

    Kronologi

    Belakangan ini, saya lagi ngebut ngebutnya melakukan SEO, dengan cara nulis artikel, di salah satu website yang sedang saya kelola. Ini tuh bener-bener posting artikel tiap hari. Setiaaaap haaaariiii… Tanpa hari tanpa posting artikel di situs ini. Nah bagi para praktisi SEO, sudah pasti pada tau, bahwa tiap kali kita posting artikel di website, akan selalu di akhiri dengan melakukan index di Google search console.

    Nah sekitar 4 minggu belakangan ini, saya posting artikel tiap hari, dan sejak kemarin, saya menemukan error saat melakukan index halaman di Google search console.

    Errornya seperti ini : Gagal: Beban host terlampaui

    Berdasarkan pesan errornya, sepintas saya berasumsi, “wah jangan – jangan error ini karena saya terlalu rutin melakukan pengindeksan di Google search console. Sampai – sampai melewati batas yang dijatahkan”. Karena memang sebelumnya, saya juga menemukan kasus, dimana dalam 1 hari, saya melakukan index sekitar 10 – 15 halaman sekaligus (angka persisnya saya lupa). Dan muncul error “Kuota Terlampaui”.

    Nah tapi kali ini errornya berbeda. Dan setelah saya libur nulis konten selama 2 hari, setelah saya coba index lagi, ternyata masih muncul error yang sama (Gagal: Beban host terlampaui). Akhirnya hari ini saya putuskan untuk menggunakan waktu istirahat makan siang saya dari jam 11 – 13 siang, untuk menyelesaikan masalah ini. Agar tidak berlarut – larut.

    Masalah

    Anehnya, saya sudah coba googling sana sini (Indo sampai english), nggak ada yang benar-benar tuntas tau apa solusi untuk masalah seperti ini. Mungkin juga karena kasus ini jarang terjadi, sehingga nggak banyak yang ngebahasnya. Ada pun yang ngebahas, mereka belum punya solusi pastinya. Bahkan di salah satu forum, pihak developer google mengatakan hal yang aneh dan nggak masuk akal.

    Mereka menduga masalah itu terjadi karena website yang bersangkuatan, disimpan di sebuah host, yang punya banyak domain (1 hosting, punya banyak website). Dan pihak pengembang juga bilang “Tidak ada solusi untuk kasus tersebut”. Itu diskusi yang aneh banget sih menurut saya.

    Dan sampai akhirnya saya tau penyebabnya, adalah hal yang sangat remeh-temeh. Yaitu masalahnya ada di file robots.txt yang ternyata memblokir Perayapan Google (crawler).

    Solusi

    Karena akhirnya, saya pelajari sendiri dan coba untuk berspekulasi, jangan-jangan ada kaitannya sama file robots.txt

    Karena aktifitas index ataupun Crawl, sangat erat hubungannya dengan robots.txt. Karena di file inilah kunci apakah Google boleh merayapi situs kita atau tidak. Nah, untuk pengaturan cepat robots.txt ini ada di menu pengaturan.

    Masalah ini selesai, hanya dengan cara ini.

    Buka pengaturan → Membaca

    Mohon di baca dan diikuti bain – baik ya

    a. Pilih “Ketampakan di mesin pencari”, di check

    b. Lalu “Simpan Perubahan”

    c. Lalu, uncheck lagi “Ketampakan di mesin pencari”

    d. Terakhir, “Simpan Perubahan” lagi

    Ini tuh sebenarnya, kita lagi melakukan “refresh” ke file robots.txt tanpa harus mengakses dan membukanya secara manual.

    Remeh temeh banget kan? 😅 Yaaaaaa, tapi selama saya berprofesi sebagai web developer, banyak banget teknik teknik remeh temeh seperti ini, tapi works.

    Nah sekarang coba deh kamu lakukan index lagi di Google search console.

    Cara ini works di saya, semoga works di kamu juga.

    Salam,
    Putu Adi.